Boltz-2
Bevezetés
A Boltz-2 egy biomolekuláris szerkezetpredikciós eszköz, amely képes fehérjék, nukleinsavak, ligandumok és különböző biomolekuláris komplexek modellezésére. A bemenetet YAML formátumú fájlban kell megadni, amely leírja a rendszer komponenseit és a számítás paramétereit.
Ebben a példában a Boltz-2 használatát a 11CE PDB azonosítójú kristályszerkezeten mutatjuk be.
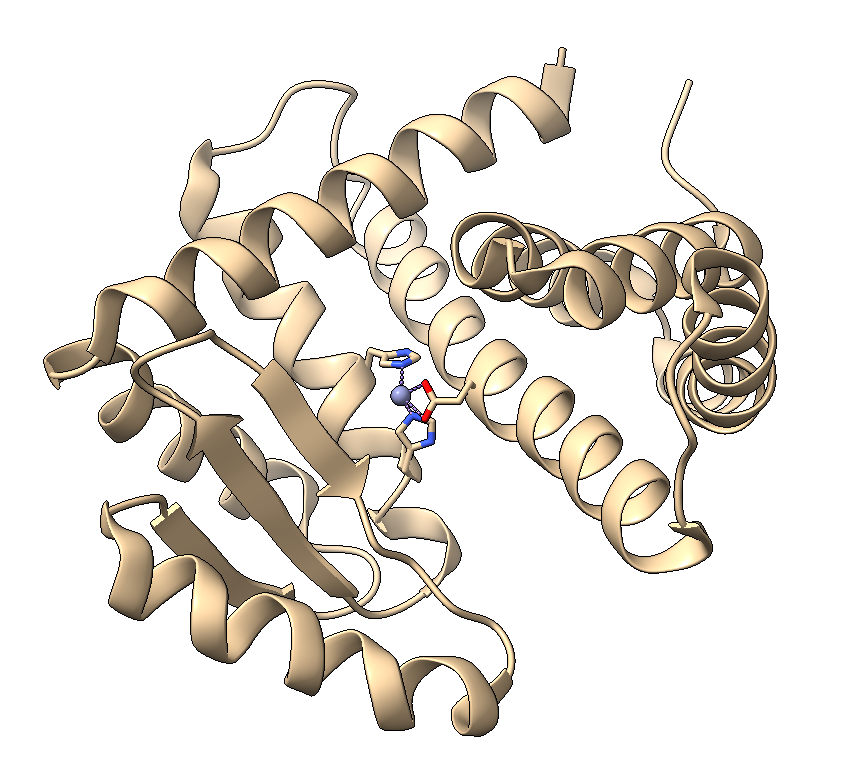
A rendszer egy fehérjét és egy koordinált cinkiont tartalmaz. A Boltz-2 input elkészítéséhez a PDB-szerkezetből kinyerjük
a fehérje aminosavsorrendjét,
a kötött cinkion(ok) jelenlétét,
a láncok azonosítóit.
A cél egy protein-ligand komplex szerkezetének előrejelzése, ahol a ligand egy kétszeresen pozitív töltésű cinkion.
FASTA szekvencia letöltése a PDB adatbázisból
Nyissuk meg a 2V0X rekordot a PDB felületén (https://www.rcsb.org/structure/11CE).
Válasszuk a “Download Files” menüt.
Töltsük le a FASTA szekvenciát.
Másoljuk a kívánt lánc aminosav-szekvenciáját az Boltz-2 .yaml input fájl megfelelő mezőjébe.
A FASTA formátum például az alábbi szerkezetet követi (rcsb_pdb_11CE.fasta):
>11CE_1|Chain A|The protease-Zn (II) complex of Zn5|synthetic construct (32630)
MSGMTAEELAERIGEALARGRWDEVYALGAYAFLTLTPEEIEEMRRRLREVLREELKKLGKTYSDEEVDRLVEAAVYEGEASAVVVRRYREEGLPEDMTDEQLFELGMLHEAYHVNFGDAYVVADGKEGIVEVLVARTEEELEEARRLAERAREEGKEVRFFKKGEEEAVIEWLREVAEKYPKVREGLIEGTRRLLEEYRKIVGSAWSHPQFEK
Boltz-2 input létrehozása
A fehérjét és a cinkiont YAML formátumban adjuk meg (11CE.yaml):
version: 1

sequences:
  - protein:
      id: A
      sequence: MSGMTAEELAERIGEALARGRWDEVYALGAYAFLTLTPEEIEEMRRRLREVLREELKKLGKTYSDEEVDRLVEAAVYEGEASAVVVRRYREEGLPEDMTDEQLFELGMLHEAYHVNFGDAYVVADGKEGIVEVLVARTEEELEEARRLAERAREEGKEVRFFKKGEEEAVIEWLREVAEKYPKVREGLIEGTRRLLEEYRKIVGSAWSHPQFEK

  - ligand:
      id: ZN
      smiles: "[Zn+2]"
A számítás futtatása
A számítás a YAML inputfájl megadásával indítható.
Online MSA szolgáltatás használatával:
boltz predict 11CE.yaml --use_msa_server
Amennyiben a szükséges adatbázisok lokálisan rendelkezésre állnak, az MSA-k helyben is előállíthatók:
boltz predict 11CE.yaml
A Boltz-2 a futás során automatikusan létrehozza a szükséges munkakönyvtárakat, majd elkészíti az MSA-kat, a szerkezetpredikciót és a konfidenciaértékeket.
A futás eredményei
A számítás befejezése után a Boltz egy eredménykönyvtárat hoz létre, amely a bemeneti fájl nevéből képződik. A könyvtárszerkezet a következőhöz hasonló:
boltz_results_11CE/
├── predictions/
│   └── 11CE/
│       ├── 11CE_model_0.cif
│       ├── confidence_11CE_model_0.json
│       └── ...
├── processed/
├── lightning_logs/
└── msa/
A legfontosabb fájlok és könyvtárak:
predictions/11CE/A predikció eredményeit tartalmazó könyvtár.
11CE_model_0.cifA prediktált szerkezet mmCIF formátumban. Ez a fájl közvetlenül megnyitható Maestro, ChimeraX vagy PyMOL programokkal.
confidence_11CE_model_0.jsonA modellhez tartozó megbízhatósági mutatókat tartalmazza. Többek között a prediktált szerkezeti bizonytalanság és a modell konfidenciaértékei találhatók benne.
processed/A Boltz által előfeldolgozott bemeneti állományokat tartalmazza. Ezeket a program a futás során automatikusan hozza létre.
lightning_logs/A PyTorch Lightning által generált naplófájlok és futtatási információk helye.
msa/A többszörös szekvenciaillesztések (MSA-k) tárolására szolgáló könyvtár. Ha a futtatás során MSA-generálás történt, az itt található fájlok kerülnek felhasználásra a modell bemeneteként.
A további elemzések során elsősorban a 11CE_model_0.cif
fájlt használjuk, amely a Boltz által legjobbnak ítélt
szerkezeti modellt tartalmazza.
Note
Egyes futtatások több modellt is generálhatnak. Ebben az
esetben a predictions könyvtárban több model_*
állomány jelenik meg. A további vizsgálatokhoz általában
a legnagyobb konfidenciájú modell használata javasolt.
A prediktált szerkezet megjelenítése
A CIF formátumban kapott szerkezet megnyitható több molekulamegjelenítő szoftverrel.
Gyakran használt programok:
PyMOL
UCSF ChimeraX
VMD
Például ChimeraX használata esetén:
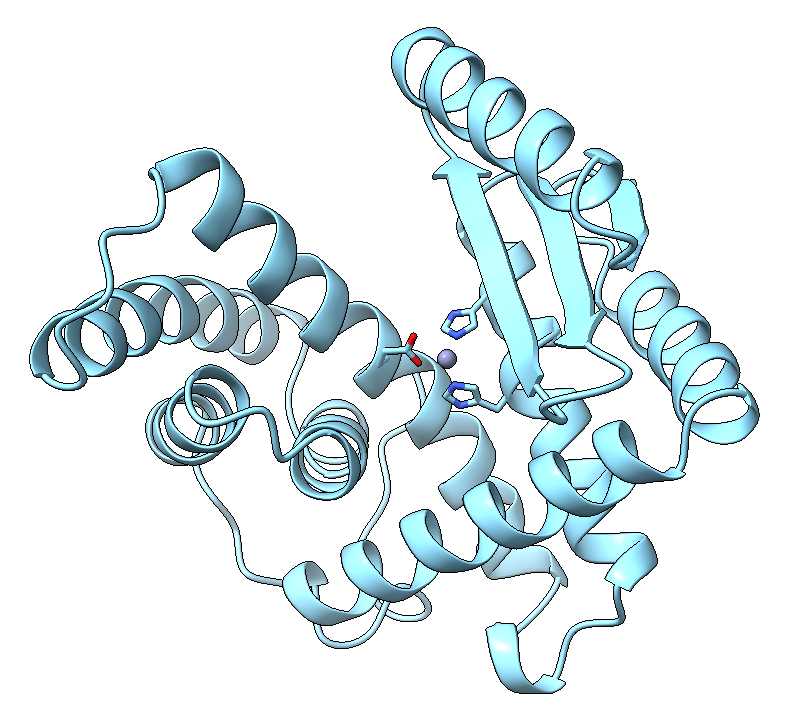
File → Open → 11CE_model_0.cif
A betöltött szerkezeten ellenőrizhető a cinkion pozíciója és a feltételezett koordinációs környezet.
A predikció konfidenciájának vizsgálata
A pLDDT értékek megjelenítése mellett érdemes megvizsgálni az AlphaFold által becsült predikciós hibát is.
Ehhez a ChimeraX beépített AlphaFold eszközeit használjuk.
A menüsorban válasszuk:
Tools → Structure Prediction → AlphaFold Error Plot
A megnyíló ablakban a ‘structure’-nél ki kell választani a 11CE_model_0.cif fájlt és ‘Predicted align error (PAE) from:’-nál a file(.json or .npy or .npz or .pkl) opciót. Ügyeljünk arra, hogy .cif-et tartalmazó mappában legyenek a PAE, plDDT és pDE-re vonatkozó output fájlok is.
A új megnyíló ablak az úgynevezett Predicted Aligned Error (PAE) mátrixot jeleníti meg.
A PAE azt mutatja meg, hogy az AlphaFold mekkora pozíciós hibát becsül két aminosav egymáshoz viszonyított elhelyezkedésére.
A grafikon értelmezése
A diagram mindkét tengelyén a fehérje aminosavai szerepelnek.
Minden pixel egy adott aminosavpárhoz tartozó becsült hibát jelöl:
alacsony érték → nagy biztonság
magas érték → bizonytalan relatív pozíció
A színskála jellemzően a következő:
Szín |
Értelmezés |
|---|---|
Sötétkék |
Nagyon alacsony becsült hiba |
Világoskék |
Alacsony becsült hiba |
Sárga |
Közepes bizonytalanság |
Narancs/Piros |
Magas becsült hiba |
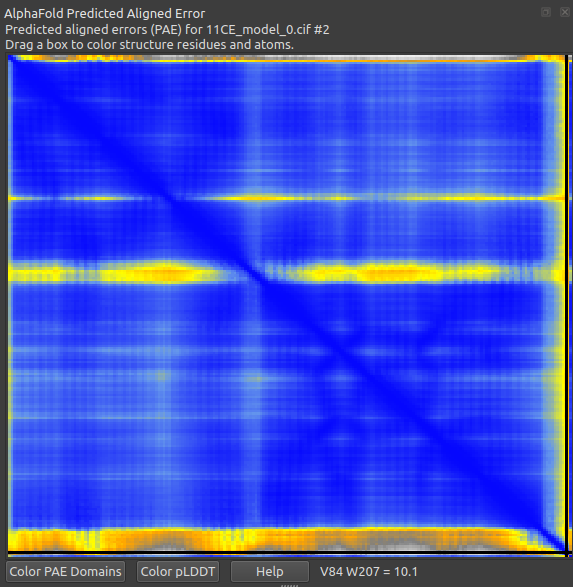
A grafikon alatt elhelyezkedő gombok segítségével lehet színezni a fehérjéjet a PAE és pLDDT értékek szerint.
A PAE és a pLDDT különbsége
A pLDDT az egyes aminosavak lokális pontosságát mutatja.
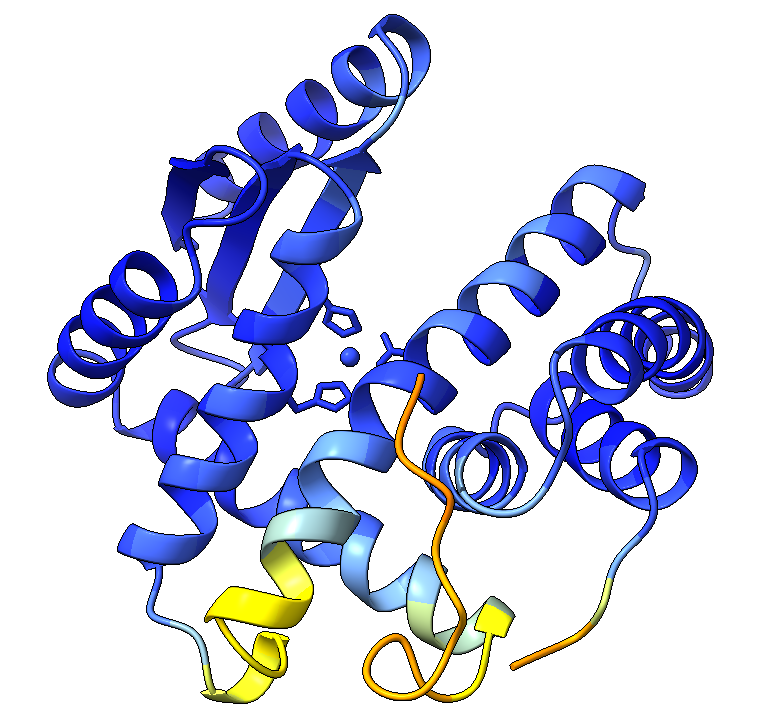
A PAE ezzel szemben azt mutatja meg, hogy két régió egymáshoz viszonyított elhelyezkedése mennyire megbízható.
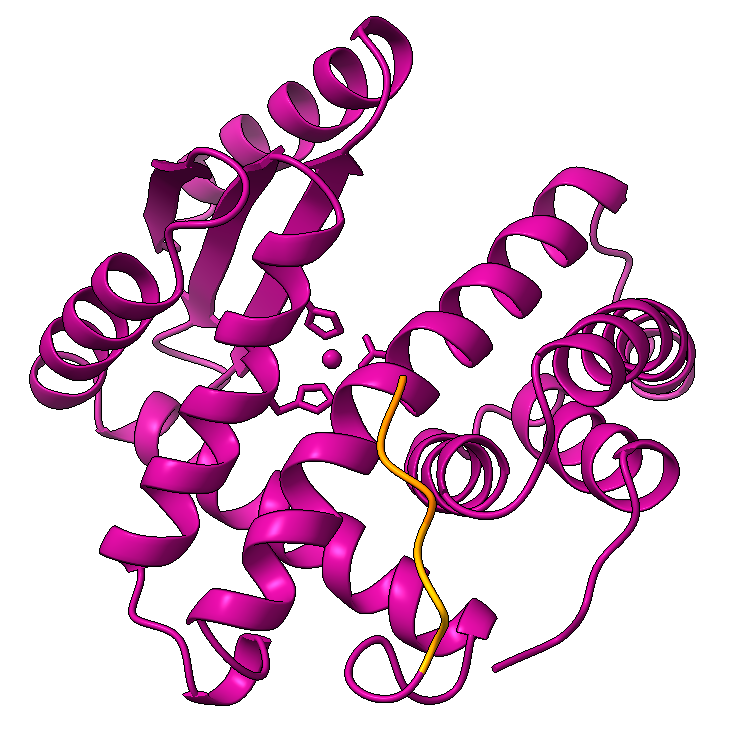
Ez különösen fontos:
több doménből álló fehérjéknél,
fehérjekomplexeknél,
homodimereknél és heterodimereknél.
A predikció összehasonlítása a kristályszerkezettel
A Boltz-2 által generált modell összehasonlítható az eredeti
11CE kristályszerkezettel. Az illesztést UCSF ChimeraX
Matchmaker algoritmusával végeztük.
A prediktált szerkezet: 11CE_model_0.cif
A referencia szerkezet: 11ce.pdb
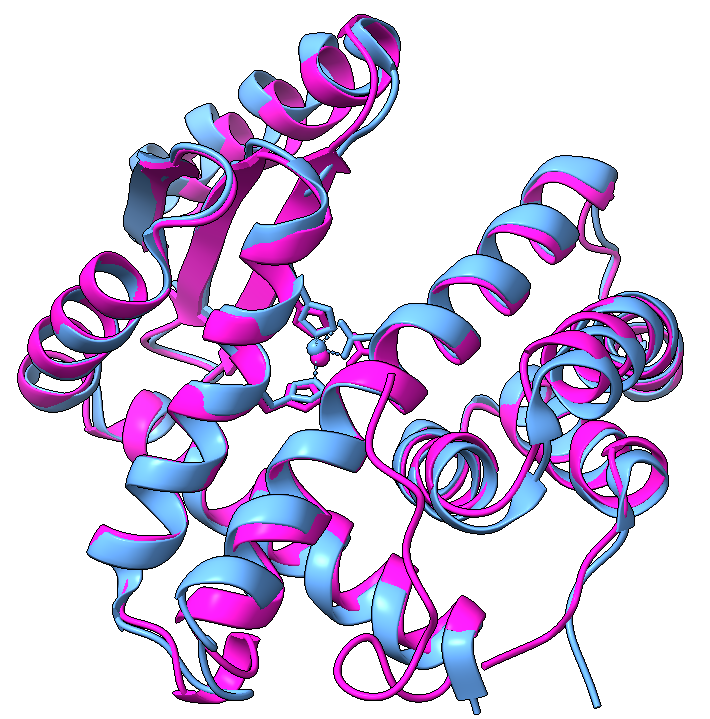
Az ábrán kék színnel látható a kristályszerkezet, rózsaszínnel pedig a Boltz-2 által meghatározott szerkezetpredikció.
Az illesztés eredménye:
Matchmaker 11CE_model_0.cif, chain A (#2)
with 11ce.pdb, chain A (#1),
sequence alignment score = 1059.7

RMSD between 191 pruned atom pairs is 0.822 angstroms;
(across all 203 pairs: 1.334)
Az RMSD érték 0,822 Å a Matchmaker által megtartott 191 atompár esetén, ami nagyon jó egyezést jelez a prediktált és a kristályosan meghatározott szerkezet között.
Ha az összes illesztett atompárt figyelembe vesszük, az RMSD 1,334 Å, ami továbbra is magas szerkezeti hasonlóságot mutat.
A kapott eredmények alapján a Boltz-2 sikeresen reprodukálja a 11CE szerkezet globális hajtogatását és a cinkiont kötő szerkezeti motívumokat.
Az eredmények értelmezése
Általánosságban:
RMSD < 1 Å: kiváló egyezés
RMSD 1-2 Å: nagyon jó egyezés
RMSD 2-4 Å: megfelelő globális szerkezet
RMSD > 4 Å: jelentős eltérés
A 11CE példában kapott 0,822 Å RMSD azt mutatja, hogy a Boltz-2 a natív szerkezethez rendkívül közeli konformációt állított elő.
Ez a példa jól demonstrálja, hogy egyszerű protein-fémion rendszerek esetén a Boltz-2 magas pontosságú szerkezeti predikcióra képes.
Továbblépési lehetőségek
A fenti példa a legegyszerűbb protein-fémion rendszerre mutat be egy teljes munkafolyamatot. A Boltz-2 azonban ennél összetettebb rendszerek kezelésére is alkalmas.
Több fehérjeláncból álló komplexek
Amennyiben a rendszer több fehérjeláncot tartalmaz, minden láncot
külön kell megadni a sequences szakaszban.
Például egy A és B láncból álló homodimer vagy heterodimer esetén:
version: 1

sequences:
  - protein:
      id: A
      sequence: MSEQNNTEMTFQIQRIYTKDISFEAPNAPHVFQ

  - protein:
      id: B
      sequence: MPEEKSAVTALWGKVNVDEVGGEALGRLLVV
A Boltz-2 ilyenkor nemcsak az egyes láncok szerkezetét becsli meg, hanem azok egymáshoz viszonyított elhelyezkedését is.
Fehérje-ligand komplexek
Kismolekulás ligandok SMILES formátumban adhatók meg.
Példa ATP hozzáadására:
version: 1

sequences:
  - protein:
      id: A
      sequence: MSEQNNTEMTFQIQRIYTKDISFEAPNAPHVFQ

  - ligand:
      id: ATP
      smiles: "Nc1ncnc2n(cnc12)[C@@H]3O[C@H](COP(O)(O)=O)[C@@2
Megpróbálja meghatározni a ligand valószínű kötődési helyét és orientációját.
Nukleinsavakat tartalmazó rendszerek
A Boltz-2 képes DNS- és RNS-szekvenciák kezelésére is.
Egyszálú DNS példa:
version: 1

sequences:
  - dna:
      id: D
      sequence: ATGCGATCGATCGATCGATC
Egyszálú RNS példa:
version: 1

sequences:
  - rna:
      id: R
      sequence: AUGCGAUCGAUCGAUCGAUC
Fehérje-DNS komplex
A fehérje és a DNS együttesen is megadható ugyanabban az inputban.
version: 1

sequences:
  - protein:
      id: A
      sequence: MKTAYIAKQRQISFVKSHFSRQLEERLGLIEVQ

  - dna:
      id: D
      sequence: ATCGATCGATCGATCGATCG
A program ilyen esetben a fehérje és a nukleinsav egymáshoz viszonyított elrendezését is megjósolja.
Fehérje–ligand–ion rendszerek
A különböző komponensek szabadon kombinálhatók.
Például egy fehérje, egy ATP molekula és egy magnéziumion:
version: 1

sequences:
  - protein:
      id: A
      sequence: MSEQNNTEMTFQIQRIYTKDISFEAPNAPHVFQ

  - ligand:
      id: ATP
      smiles: "Nc1ncnc2n(cnc12)[C@@H]3O[C@H](COP(O)(O)=O)[C@@H](O)[C         id: MG
      smiles: "[Mg+2]"
Kovalensen kötött ligandok
A Boltz-2 támogatja kovalensen kapcsolódó módosítások kezelését is. Ilyenkor a molekulák közötti kötéseket külön meg kell adni a megfelelő szekcióban.
Tipikus alkalmazások:
foszforiláció,
glikoziláció,
kovalens inhibitorok,
kromofórok,
prosztetikus csoportok.
Összetett rendszerek
A legösszetettebb inputok több fehérjét, nukleinsavat, ligandumot és iont is tartalmazhatnak egyszerre.
Például:
version: 1

sequences:
  - protein:
      id: A
      sequence: ...

  - protein:
      id: B
      sequence: ...

  - dna:
      id: D
      sequence: ...

  - ligand:
      id: ATP
      smiles: ...

  - ligand:
      id: MG
      smiles: "[Mg+2]"
Ilyen rendszerekkel transzkripciós faktorok, enzim-komplexek vagy ribonukleoprotein szerkezetek vizsgálhatók.